用照片制作的头像不是生成任务,而是转换任务:已经有一张脸,你只是希望换一种风格重新绘制。
这一区别决定了哪种工具能做到。你用提示词描述自己——”深色卷发,三十出头,黄色毛衣”——得到的只是一个符合该描述的人,不是你本人。描述是一个类别,而你的脸只是其中的一个实例,这正是图转提示再转图所面临的瓶颈。
第一轮——初始肖像
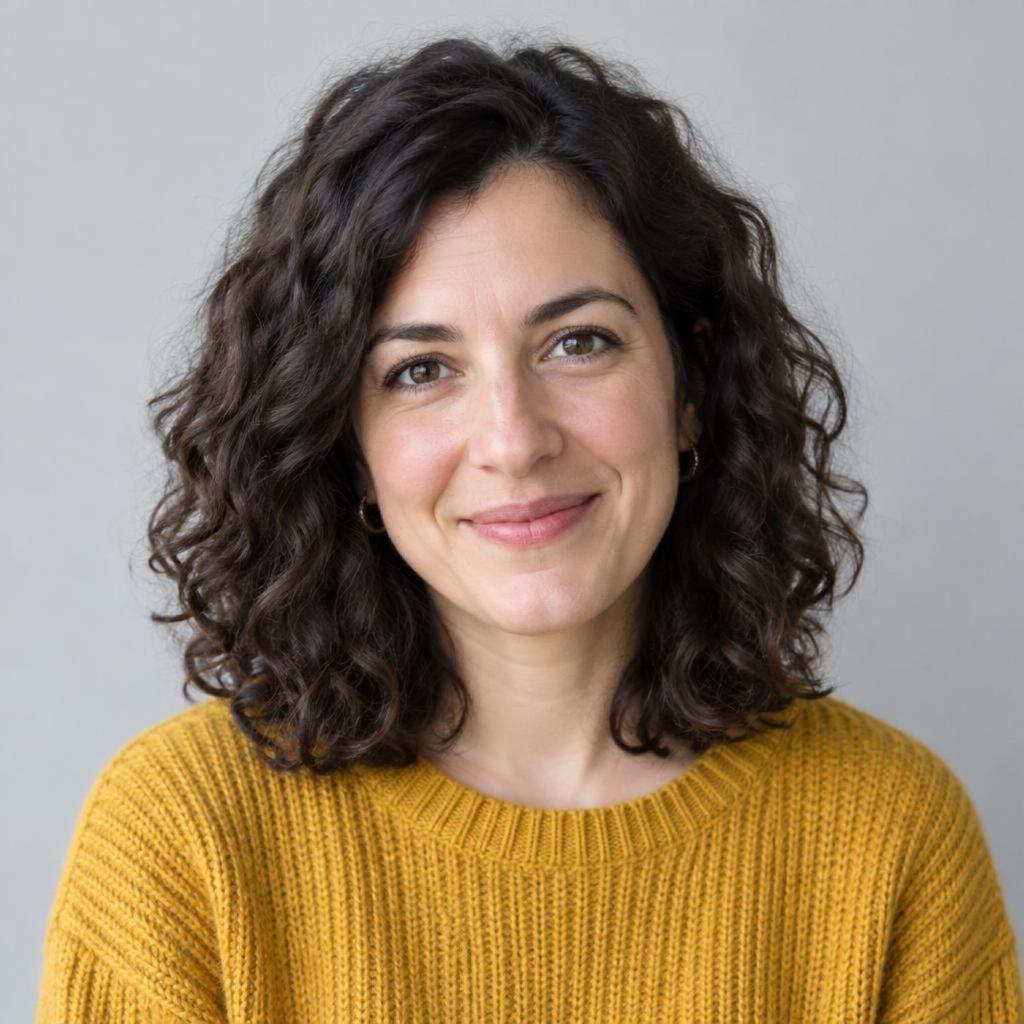
首先必须说明一个重要前提:这张肖像本身就是生成的,并非真实人物的照片。我们稍后会回到这一点为何重要,因为这是本次测试中最薄弱的一环。
第二轮——变换媒介,保留人物
把这张图转成扁平矢量插画风格的头像,保留发型轮廓和毛衣颜色
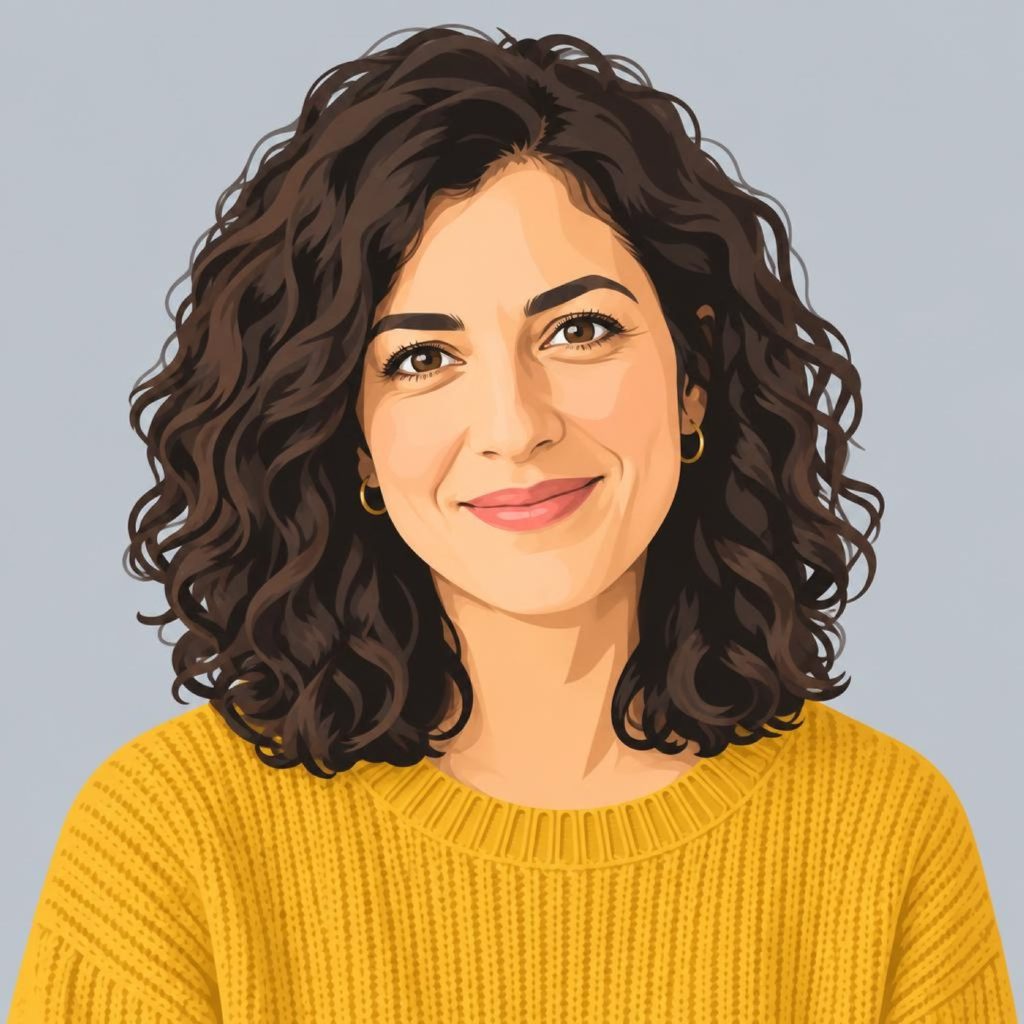
这是效果最好的一环。卷发的形状完全一致——不是某种通用的卷发,而是相同的卷曲形态,以相同的方式垂落。金色圆环耳环保留了,毛衣仍是芥末黄,甚至连罗纹针织的纹理依然清晰可辨。这张脸被重新绘制后,仍然能被认出是同一个人。
能做到这一点,是因为模型是在编辑图像,而不是在凭空想象一个人。没有从描述中重构任何东西,因此没有任何需要猜测的部分。
第三轮——让它适配为头像照片
裁得更紧凑,只保留头部和肩部,后面放一个纯青色圆形
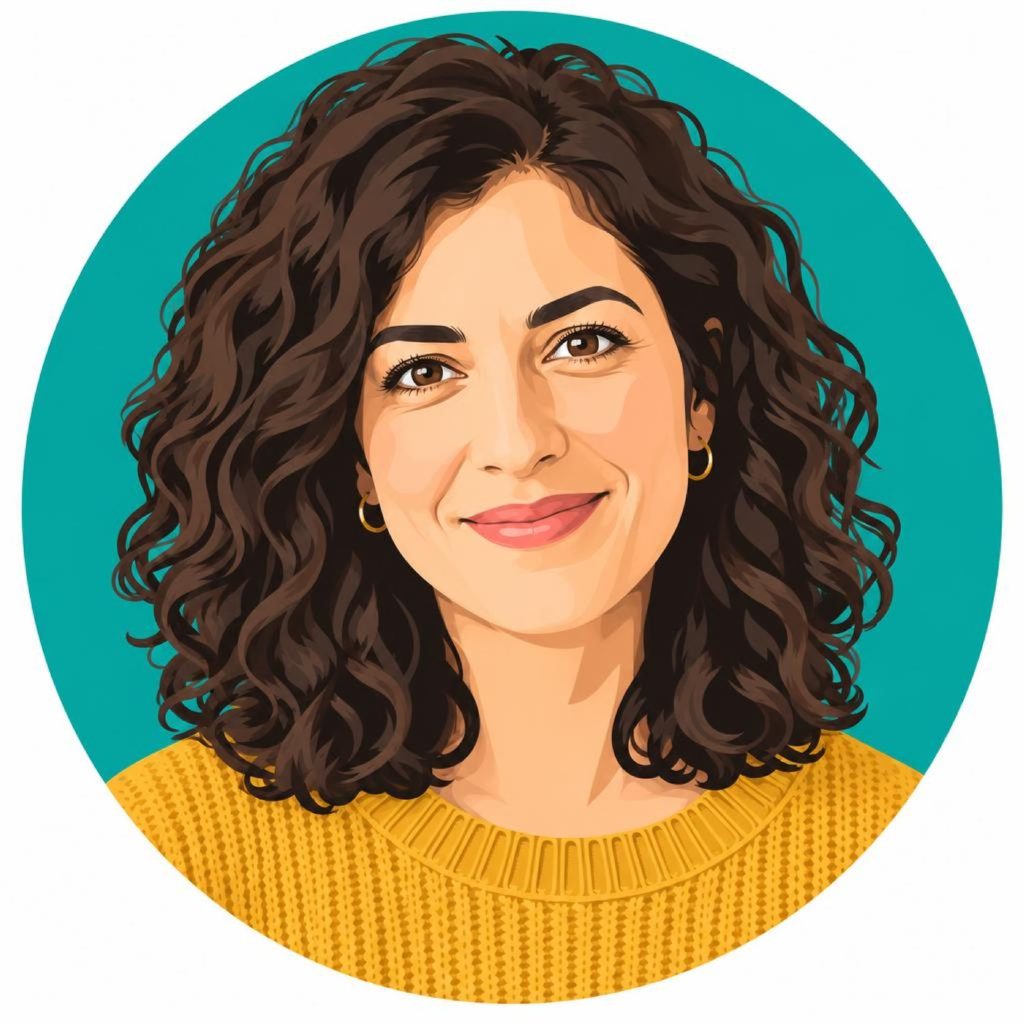
一半成功,理应如实说明。青色圆形完全按要求出现了,但”裁得更紧凑”这部分几乎没怎么生效——构图只是稍微推进了一点,距离头像照片通常需要的紧凑头肩裁剪还差得远。
这是一个反复出现的模式:复合指令往往只执行了具体部分,而模糊部分则被近似处理。“在后面放一个青色圆圈”是具体的。“裁剪得更紧凑”是相对的——比什么更紧凑,幅度多少?将它们分成两轮,或者给出一个可衡量的版本:“裁剪以使头部填满大部分画面。”
我们无法测试的部分,也是你应该尝试的
上面的所有内容都始于生成的面孔。坦率地说,这是简单的情况:它们往往位于模型认为自然的绘制范围的中间,因此风格变化很难将它们拉离。
真实人物的真实照片更难,而且难在关键之处。让人认出你的通常是少数几个微小的不对称特征——一只眉毛的形状、特定的鼻梁、嘴的一侧移动方式。风格迁移往往会规范化这些特征,结果可能是一个很好的例子,证明你的朋友认不出那是你。
我们不会宣称我们没有测量的结果。我们可以说的是如何低成本地发现这一点:以低成本运行你自己的照片一轮,然后展示给一个认识你脸但不知道那是什么的人。如果他们犹豫了,相似度就没有保留下来,更多的轮次也无法将其找回。
两个实用提示
- 使用你有权使用的照片。 你自己的脸,或者你有明确许可的脸。将别人的照片变成头像,在技术问题之前,首先是一个许可问题。
- 保留你喜欢的这一轮。 风格会分叉——扁平矢量、水彩、线稿都来自同一个原始肖像。从原始图像分叉,而不是在风格上堆叠风格,否则你会得到一个插图中的插图。
底层的循环与产品拍摄和缩略图相同:从真实的事物开始,改变一件事,保留有效的部分。能够实现“保留有效部分”的是 有效的图像到图像。
注册即送 300 积分,直接开始 — 无需绑卡